RAG sobre tus documentos
40 minIntermedio
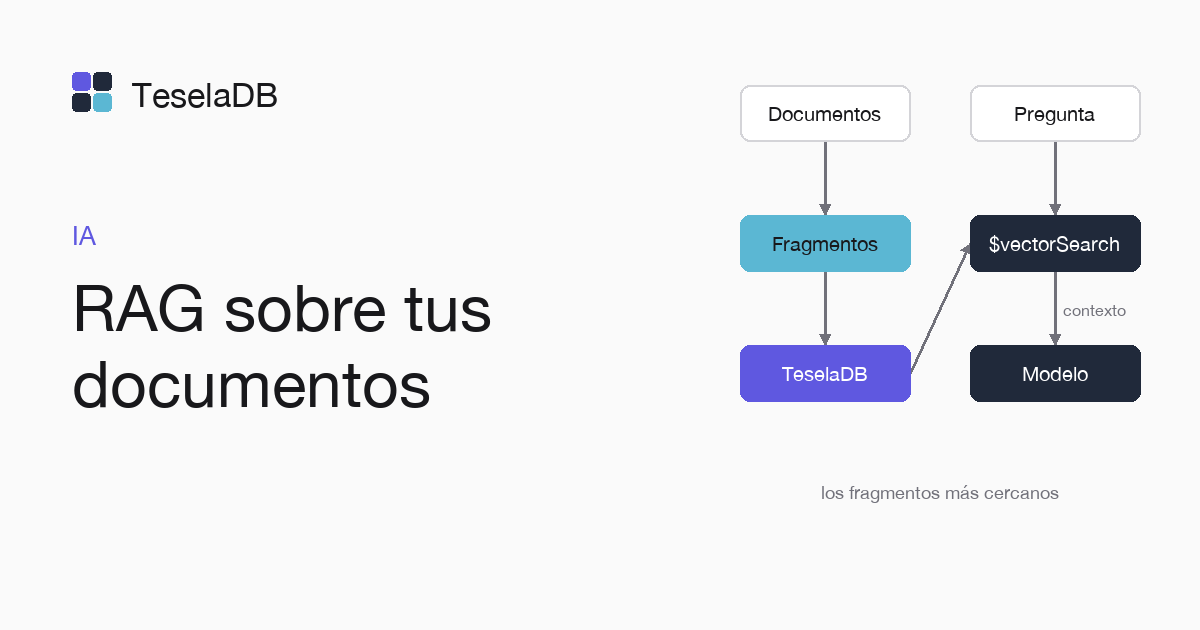
En esta guía aprenderás a partir tus documentos en fragmentos, guardarlos con su vector y dar al modelo los más cercanos a cada pregunta.
Un modelo de lenguaje responde mejor sobre tus documentos si le das, junto a la pregunta, los fragmentos que tratan de
ella. Aquí guardas cada fragmento en TeselaDB con su vector y recuperas los más cercanos con $vectorSearch para montar el
texto que le pasas al modelo.
Lo que vas a construir
Dos scripts de Python. ingest.py parte cada fichero Markdown de docs/ en párrafos y los guarda en kb.chunks con
su vector y su fichero de origen. ask.py recupera los tres párrafos más cercanos a una pregunta y escribe el prompt
con esos párrafos y su origen.
Requisitos
- Python 3.9 o posterior y una carpeta
docs/con tus documentos en Markdown. - Docker y
mongosh, para arrancar TeselaDB en tu máquina y mirar los datos. - PyMongo y sentence-transformers. Los ejemplos usan el modelo
all-MiniLM-L6-v2, de 384 dimensiones:
pip install pymongo sentence-transformersPrepara el entorno
docker run -d --name teseladb -p 27017:27017 viuzi/teseladb:latest \
  start --dbpath /data --insecure --insecure-allow-remote --bind_ip 0.0.0.0
export TESELADB_URI="mongodb://127.0.0.1:27017/kb"
mongosh "$TESELADB_URI" --quiet --eval 'db.runCommand({ ping: 1 }).ok'
El contenedor arranca un nodo de TeselaDB sin TLS ni usuarios, que basta para seguir la guía en tu máquina. Cuando mongosh responde 1, el nodo ya acepta conexiones. TESELADB_URI apunta a ese nodo y a la base kb; en un clúster de producción la cadena lleva TLS y usuario, como cuenta Conectar tu aplicación.
1. Guarda los fragmentos
Guarda esto como ingest.py. Un párrafo por fragmento es un punto de partida sencillo; con documentos largos, parte
por secciones o por un número fijo de palabras:
import os
from pathlib import Path

from pymongo import MongoClient
from pymongo.operations import SearchIndexModel
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("all-MiniLM-L6-v2")
chunks = MongoClient(os.environ["TESELADB_URI"]).kb.chunks

# One chunk per paragraph, with the file it comes from and its vector.
for path in Path("docs").glob("*.md"):
    paragraphs = [p.strip() for p in path.read_text().split("\n\n") if p.strip()]
    chunks.insert_many(
        {"source": path.name, "text": text, "embedding": model.encode(text).tolist()} for text in paragraphs
    )

chunks.create_search_index(SearchIndexModel(
    name="chunks",
    type="vectorSearch",
    definition={"fields": [{"type": "vector", "path": "embedding", "numDimensions": 384, "similarity": "cosine"}]},
))
print(chunks.count_documents({}), "chunks")
2. Recupera el contexto de una pregunta
Guarda esto como ask.py. El prompt pide al modelo que responda solo con el contexto y que cite el fichero de cada dato:
import os
import sys

from pymongo import MongoClient
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("all-MiniLM-L6-v2")
chunks = MongoClient(os.environ["TESELADB_URI"]).kb.chunks


def context_for(question: str, limit: int = 3) -> list[dict]:
    return list(chunks.aggregate([
        {"$vectorSearch": {"index": "chunks", "path": "embedding", "queryVector": model.encode(question).tolist(),
                           "numCandidates": 100, "limit": limit}},
        {"$project": {"_id": 0, "source": 1, "text": 1}},
    ]))


question = sys.argv[1]
context = context_for(question)
prompt = "Answer only with this context and cite the source of each fact.\n\n"
prompt += "\n\n".join(f"[{c['source']}] {c['text']}" for c in context)
prompt += f"\n\nQuestion: {question}"
print(prompt)
Probarlo
Con dos ficheros en docs/, uno sobre añadir nodos y otro sobre drenarlos, guarda los fragmentos y pregunta, esperando
unos segundos entre las dos órdenes para que el índice vectorial que crea ingest.py termine de construirse antes de que
ask.py lo consulte:
python ingest.py
python ask.py "how do I take a machine out of the cluster?"
El prompt empieza por el párrafo de drain.md, aunque la pregunta, que es cómo sacar una máquina del clúster, no
dice «drain». Pásalo al modelo de lenguaje que
uses como mensaje del usuario.
Limpiar
db.getSiblingDB("kb").chunks.drop();Ejecútala desde mongosh al terminar. Al borrar kb.chunks se borra también su índice vectorial y no queda nada de la
prueba en la base kb. Al final borra también el contenedor con la última orden: el nodo guarda los datos dentro, sin volumen, así que con él desaparece todo lo que escribiste durante la guía y el puerto 27017 queda libre.
docker rm -f teseladbSiguientes pasos
- Búsqueda semántica con $vectorSearch, con los filtros y
exact. - Memoria para un agente de IA, para recordar lo que dice cada usuario.