Memoria para un agente de IA
25 minIntermedio
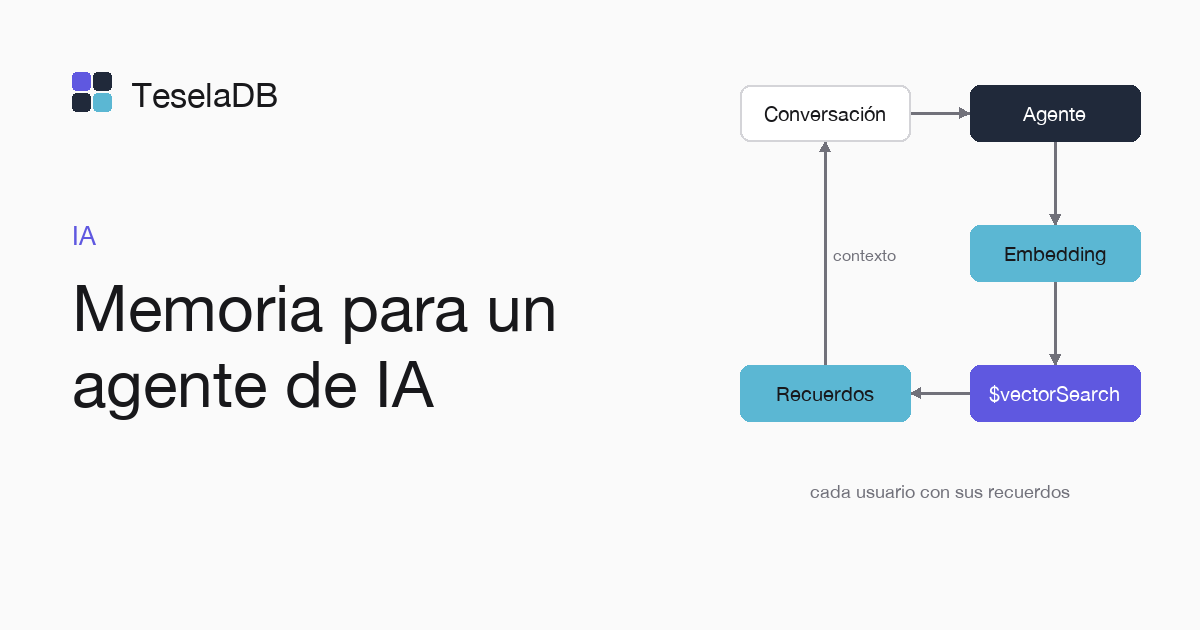
Un agente puede recordar a cada usuario si guarda lo que aprende con su vector y recupera lo más parecido a la conversación actual.
Un agente que recuerda a cada usuario guarda frases cortas, como una preferencia o un dato de su proyecto, y en cada conversación recupera las que más se parecen a lo que se está hablando. En TeselaDB, esas memorias son documentos con su vector, un índice vectorial con un filtro por usuario y un índice TTL que las olvida pasado un tiempo.
Lo que vas a construir
Una colección memories en la base agent con un índice vectorial filtrado por userId y una consulta que devuelve
las dos memorias de un usuario más cercanas a la conversación. Las memorias de más de 90 días se borran solas.
Requisitos
- Docker y
mongosh, para arrancar TeselaDB en tu máquina y mirar los datos. - Un modelo de embeddings para tus textos. Los ejemplos usan vectores de tres dimensiones escritos a mano para que
veas el resultado exacto; con un modelo real,
numDimensionses el tamaño de sus vectores.
Prepara el entorno
docker run -d --name teseladb -p 27017:27017 viuzi/teseladb:latest \
  start --dbpath /data --insecure --insecure-allow-remote --bind_ip 0.0.0.0
export TESELADB_URI="mongodb://127.0.0.1:27017/agent"
mongosh "$TESELADB_URI" --quiet --eval 'db.runCommand({ ping: 1 }).ok'
mongosh "$TESELADB_URI"
El contenedor arranca un nodo de TeselaDB sin TLS ni usuarios, que basta para seguir la guía en tu máquina. Cuando mongosh responde 1, el nodo ya acepta conexiones. TESELADB_URI apunta a ese nodo y a la base agent; en un clúster de producción la cadena lleva TLS y usuario, como cuenta Conectar tu aplicación. La última línea abre mongosh sobre esa base para los pasos de la guía.
1. Guarda las memorias
Cada memoria lleva el usuario, el texto, su vector y la fecha. Dos son de Ana y una de Luis, cuyo vector está cerca de uno de los de Ana, así que después puedes comprobar que la búsqueda de un usuario nunca devuelve las memorias del otro:
db.memories.insertMany([
  { userId: "ana", text: "Prefiere respuestas en español", embedding: [0.9, 0.1, 0.0], createdAt: new Date() },
  { userId: "ana", text: "Trabaja con un clúster de tres nodos", embedding: [0.1, 0.9, 0.1], createdAt: new Date() },
  { userId: "luis", text: "Prefiere respuestas cortas", embedding: [0.8, 0.2, 0.1], createdAt: new Date() },
]);
2. Crea el índice vectorial
El campo userId va como filtro, así que una búsqueda nunca mezcla las memorias de dos usuarios. El bucle espera a
que el índice se pueda consultar:
db.memories.createSearchIndex({
  name: "memory",
  type: "vectorSearch",
  definition: {
    fields: [
      { type: "vector", path: "embedding", numDimensions: 3, similarity: "cosine" },
      { type: "filter", path: "userId" },
    ],
  },
});
while (!db.memories.getSearchIndexes("memory")[0]?.queryable) sleep(100);
3. Olvida lo antiguo
Un índice TTL sobre createdAt borra cada memoria 90 días después de guardarla:
db.memories.createIndex({ createdAt: 1 }, { expireAfterSeconds: 60 * 60 * 24 * 90 });Probarlo
Busca las dos memorias de Ana más cercanas al vector de la conversación, [1, 0, 0] en este ejemplo. Con
exact: true la búsqueda compara con todos los vectores y da el mismo resultado en cualquier réplica. El filtro la
deja dentro de las memorias de Ana:
db.memories.aggregate([
  {
    $vectorSearch: {
      index: "memory",
      path: "embedding",
      queryVector: [1, 0, 0],
      exact: true,
      limit: 2,
      filter: { userId: "ana" },
    },
  },
  { $project: { _id: 0, text: 1 } },
]);[
{ text: 'Prefiere respuestas en español' },
{ text: 'Trabaja con un clúster de tres nodos' }
]Las memorias de Luis no aparecen aunque su vector esté cerca, porque el filtro deja fuera a los demás usuarios. Si
tu agente usa MCP, la herramienta aggregate del servidor MCP lanza esta misma consulta.
Limpiar
db.memories.drop();Al borrar la colección de prueba se borran también sus dos índices, el vectorial y el TTL. Al final borra también el contenedor con la última orden: el nodo guarda los datos dentro, sin volumen, así que con él desaparece todo lo que escribiste durante la guía y el puerto 27017 queda libre.
docker rm -f teseladbSiguientes pasos
- Búsqueda vectorial, con la búsqueda aproximada y sus opciones.
- Conectar un agente de IA con MCP, para darle al agente acceso a sus memorias.