Actualizar sin parar el servicio
40 minIntermedio
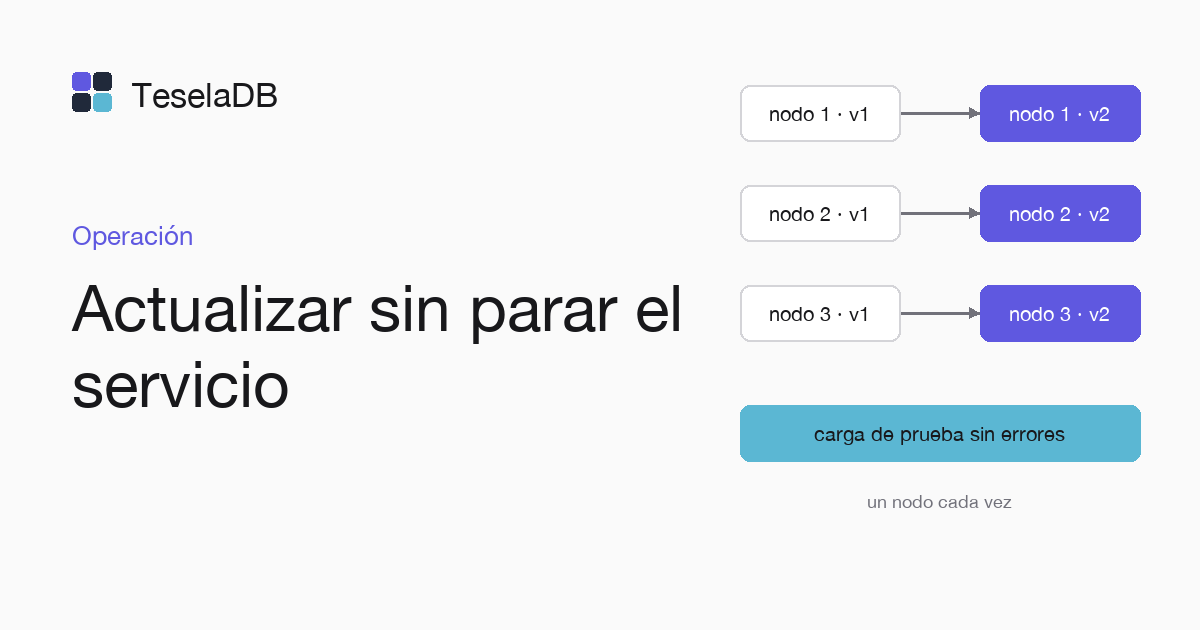
Al cambiar el binario de un clúster de tres nodos uno a uno, una carga de prueba sigue escribiendo sin fallos.
Un clúster de tres nodos sigue sirviendo con uno parado, porque cada rango conserva la mayoría de sus réplicas. Esa es la base de una actualización sin parada: cambias el binario de un nodo, esperas a que vuelva y pasas al siguiente.
Lo que vas a construir
Un clúster de tres nodos actualizado a una versión nueva, nodo a nodo, con una carga de prueba que escribe un documento por segundo durante toda la actualización y cuenta las escrituras que fallan.
Requisitos
- Un clúster de tres nodos como servicio de systemd (Tres máquinas con systemd).
- El binario de la versión nueva en cada máquina y las notas de esa versión leídas.
mongoshconectado al clúster comoroot, con la orden del paso 4 de esa guía.
1. Arranca la carga de prueba
En otra terminal, con mongosh sobre los tres nodos, escribe un documento por segundo durante diez minutos:
let fallos = 0;
for (let i = 0; i < 600; i++) {
  try {
    db.carga.insertOne({ i, at: new Date() });
  } catch (error) {
    fallos += 1;
  }
  sleep(1000);
}
print(`escrituras fallidas: ${fallos}`);
2. Actualiza un nodo cada vez
Ejecuta las órdenes de abajo primero en node-03, después en node-02 y por último en node-01, para que solo haya un
nodo parado cada vez mientras los otros dos conservan la mayoría de las réplicas de cada rango:
sudo systemctl stop teseladb
sudo install -m 0755 ./teseladb /usr/local/bin/teseladb
sudo systemctl start teseladb
sudo teseladb admin --dbpath /var/lib/teseladb nodes
No pases al siguiente hasta que nodes liste el nodo actualizado como activo. No drenes los nodos, porque el drenado sirve
para retirarlos del clúster.
3. Activa la versión de MongoDB nueva, si la hay
Si las notas de la versión dicen que anuncia una versión de MongoDB más reciente, súbela cuando los tres nodos tengan el binario nuevo, como explica Actualizar entre versiones.
Probarlo
Cuando acaba la carga, escribe cuántas escrituras fallaron. Los drivers reintentan una vez las escrituras que pillan un cambio de líder, así que lo normal es que dé cero:
escrituras fallidas: 0Limpiar
db.carga.drop();Ejecútala en mongosh cuando la carga haya escrito su resultado, para borrar la colección carga que llenó la prueba.
Siguientes pasos
- Política de versiones y soporte, para saber cuánto se mantiene tu versión.
- Matar un nodo y verlo volver, con una caída sin avisar.