Un grupo Raft por rango
Por qué cada rango de TeselaDB acuerda sus escrituras con sus propias réplicas y qué ganas con ello.
5 min de lectura
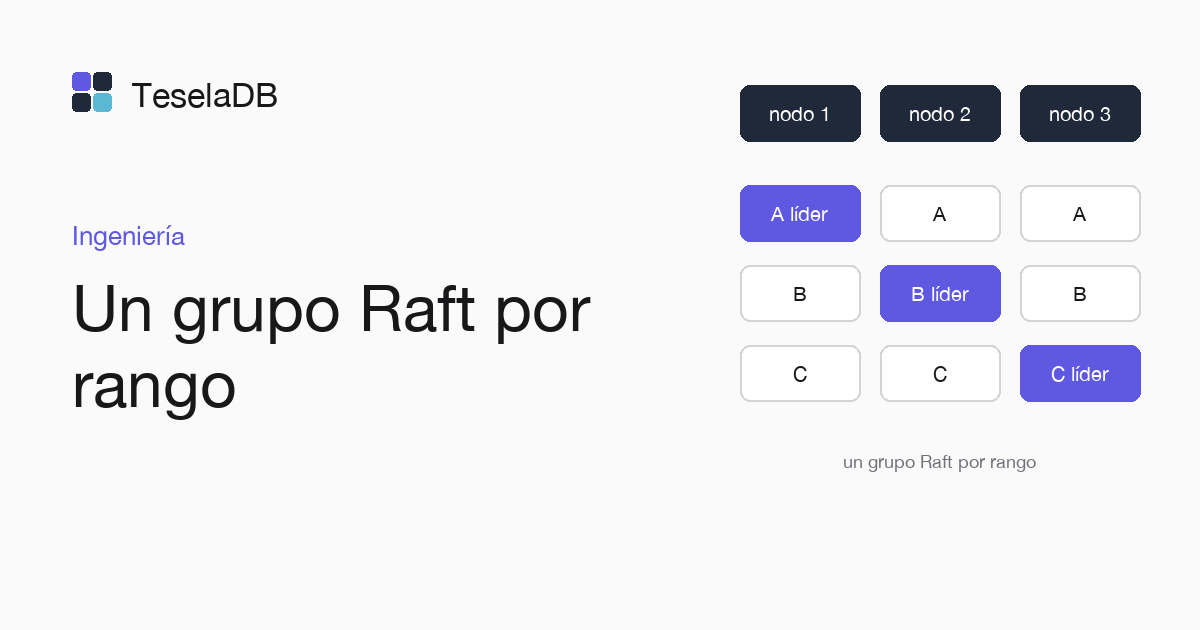
En TeselaDB, cada rango de claves es un grupo Raft propio. Sus réplicas acuerdan el orden de sus escrituras entre ellas, sin pasar por un coordinador central, y un clúster con miles de rangos tiene miles de grupos que avanzan cada uno a su ritmo. De esa decisión salen casi todas las garantías que ve tu aplicación, desde lo que espera una escritura hasta lo que pasa cuando un nodo queda aislado de los demás.
Qué es un rango
Un rango es un intervalo [inicio, fin) del espacio de claves ordenado. Una colección empieza en un rango y se divide
cuando supera 64 MiB de datos vivos o 512 MiB en disco con sus versiones, o cuando recibe demasiada carga. Cada rango
tiene sus réplicas en varios nodos. El clúster replica los datos rango a rango. También los reparte entre nodos y los
divide con esa misma unidad.
   rango 42                 rango 43
 ┌─────────────┐         ┌─────────────┐
 │ líder  n1   │         │ líder  n2   │
 │ réplica n2  │         │ réplica n3  │
 │ réplica n3  │         │ réplica n1  │
 └─────────────┘         └─────────────┘
Cómo se confirma una escritura
Una réplica de cada rango es la líder. Propone las escrituras en su log, y una entrada se aplica cuando la tiene en
disco la mayoría de las réplicas. Cuándo te responde depende del write concern que pidas. Con w: "majority", la
respuesta llega cuando la mayoría ha guardado la entrada con fdatasync y la líder la ha aplicado. Con w: 1 basta con
que la entrada esté en el log de la líder. Si añades j: true, también tiene que estar en su disco. Pedir más réplicas de las que tiene el
rango falla con UnsatisfiableWriteConcern (100), igual que en MongoDB. Una parada ordenada del nodo lleva a disco todo
lo que su log ya tenía, también lo confirmado con w: 1, mientras que una caída sí puede perderlo.
Leer sin preguntar
Mientras dura su lease, la líder sabe que ninguna otra réplica puede haber confirmado escrituras, así que responde las
lecturas sin mandar un solo mensaje. Una líder recién elegida todavía no tiene lease y confirma su liderazgo con
ReadIndex antes de leer. Las lecturas linearizable lo confirman siempre, aunque haya lease, como MongoDB confirma la
mayoría en cada lectura de ese tipo. Un seguidor también puede servir lecturas, hasta su marca cerrada, que la líder
publica 3 segundos por detrás de su reloj.
Escrituras que se pueden repetir
Cuando un driver pierde la respuesta de una escritura, por ejemplo porque la conexión se cortó justo después de que el nodo la recibiera, la reenvía con la misma sesión y el mismo número de sentencia. Para que no se aplique dos veces, cada rango guarda una tabla con el identificador de sesión, el número de transacción y el número de sentencia de cada escritura y su resultado. Si llega otra vez la misma escritura, el rango devuelve el resultado guardado sin repetirla. La tabla se purga a los 30 minutos y viaja dentro de las instantáneas del rango, de modo que una réplica nueva también la conoce.
Cuando la líder queda aislada
Si una partición de red separa a la líder del resto, deja de poder confirmar escrituras y su lease caduca. La mayoría
elige otra líder entre las réplicas que quedan. Los drivers no tienen que saber quién es. El nodo que reciben les
contesta NotLeader con la pista de la líder nueva, y el cliente interno de TeselaDB sigue esa pista o prueba la
réplica siguiente. Para tu aplicación, el cambio se nota como una operación que tarda un poco más o que se reintenta.
Muchos grupos en cada núcleo
Un nodo lleva muchos rangos. Cada núcleo de cada nodo lleva muchos grupos a la vez, y su log de Raft es también el log de escritura del almacenamiento, así que una escritura no se guarda dos veces en disco. Un grupo inactivo no envía latidos, y por eso miles de rangos quietos no generan tráfico de Raft entre los nodos. Una entrada de Raft admite hasta 64 MiB, pero viaja por la red en trozos de 1 MiB como mucho, igual que la instantánea con la que una réplica nueva se pone al día. Los metadatos del clúster, con los nodos, el catálogo y la lista de rangos, viven en otro grupo Raft, Group 0.
Qué ganas
Los rangos son independientes entre sí. Un problema en uno no frena a los demás, porque cada grupo elige su líder y
confirma sus escrituras sin esperar a ningún otro. Si cae un nodo, cada rango que lideraba elige
una líder nueva entre sus réplicas y sigue aceptando escrituras mientras responda la mayoría. Una escritura confirmada
con w: "majority" sobrevive a la caída de cualquier minoría de réplicas de su rango.
Lo que cuesta
Un rango necesita la mayoría de sus réplicas para aceptar escrituras, así que cada escritura espera al disco de esa mayoría. Si repartes las réplicas entre centros de datos lejanos, esa espera se nota en la latencia de cada escritura, porque cada confirmación incluye el viaje de ida y vuelta hasta las réplicas que forman la mayoría. Las páginas Consenso con Raft en cada rango y Rangos y réplicas cuentan lo mismo como referencia.
Etiquetas
- Raft
- rangos
- replicación