Así es TeselaDB
Una base de datos documental que implementa el protocolo de MongoDB 9.0 y reparte cada colección en rangos replicados.
5 min de lectura
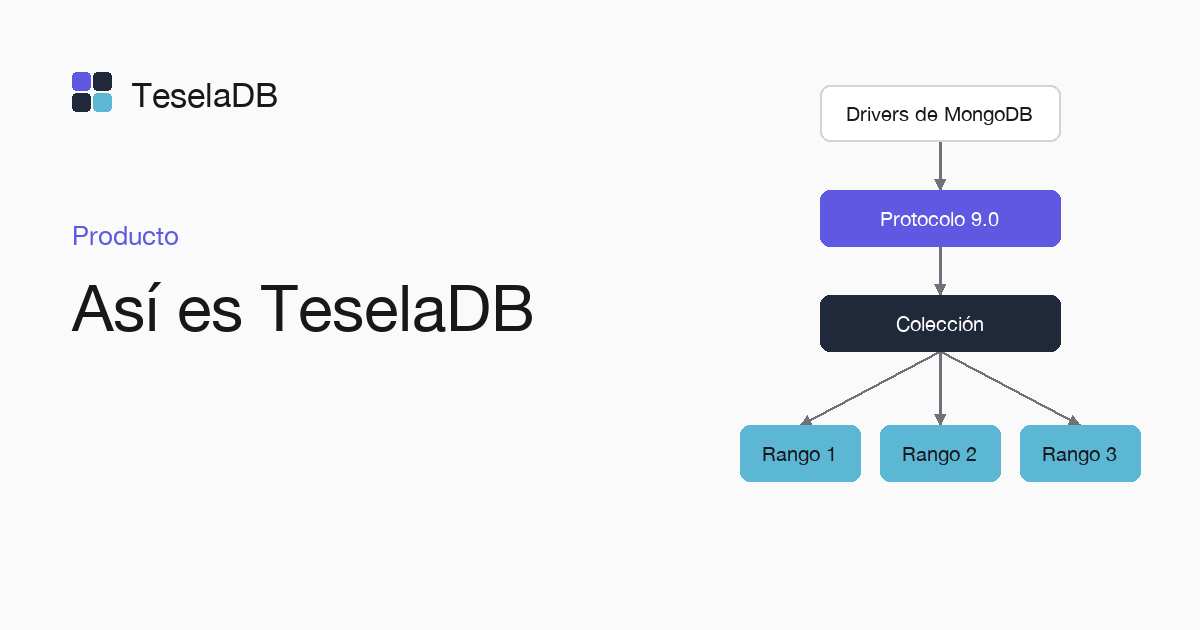
TeselaDB es una base de datos documental distribuida. Guarda documentos BSON, implementa el protocolo de MongoDB 9.0 y
reparte cada colección en rangos que se replican entre los nodos del clúster. Tus aplicaciones se conectan con los
drivers oficiales de MongoDB y con mongosh, y herramientas como Compass o las Database Tools funcionan igual, así que
el primer contacto se parece mucho a conectarse a un MongoDB más.
Un binario, nodos iguales
Un solo binario, teseladb, es el nodo, el router y la herramienta de administración. Todos los nodos son iguales. No
hay servidores de configuración ni procesos auxiliares que desplegar aparte, porque los metadatos del clúster viven en
un grupo Raft repartido entre esos mismos nodos. Dentro de cada nodo, un hilo por núcleo de CPU es dueño de sus rangos,
de su log y de su almacenamiento. Para crecer, arrancas el binario en otra máquina con un token de alta y el clúster
empieza a darle réplicas. El mismo binario arranca un clúster de desarrollo de tres nodos en un solo proceso con
teseladb dev.
Rangos que se reparten solos
Cada colección se divide en rangos de claves. Un rango se parte cuando supera 64 MiB de datos vivos o 512 MiB en disco
con sus versiones, o cuando recibe demasiadas operaciones. Dos vecinos pequeños y fríos se fusionan. El equilibrador
mueve réplicas y líderes entre los nodos hasta que la carga y el espacio libre quedan parejos. No eliges ninguna shard
key. Si ya usas shard keys o zonas, siguen funcionando con la semántica de MongoDB, y para una clave que siempre crece,
como una fecha, un índice con teselaBuckets reparte sus entradas en cubos. Con teseladb admin ranges ves en cualquier momento los
rangos de una colección, con sus límites y sus réplicas.
Cada rango, su propio Raft
Cada rango es un grupo Raft con su líder y sus réplicas. Una escritura se confirma cuando la tiene en disco la mayoría
de las réplicas de su rango, y una escritura confirmada con w: "majority" sobrevive a la caída de cualquier minoría.
Si cae un nodo, los rangos que lideraba eligen otro líder entre las réplicas que quedan y los drivers reintentan la
operación en curso. Como los rangos son independientes, un problema en uno no frena a los demás.
Transacciones entre rangos y nodos
Una transacción puede tocar documentos de varios rangos en nodos distintos y se confirma de forma atómica, con
aislamiento por instantánea. Las marcas de tiempo salen de relojes lógicos híbridos, así que no hace falta un reloj
central ni relojes atómicos. withTransaction de los drivers reintenta lo que debe, como con MongoDB, y una transacción
se anula al pasar de 60 segundos por defecto.
Búsqueda dentro de la base
Los índices de búsqueda de texto y vectoriales se crean con las mismas órdenes que en Atlas, y $search y
$vectorSearch funcionan en el pipeline de agregación. La diferencia es que viven dentro de la base. Una búsqueda ve
todas las escrituras confirmadas antes de que empiece, sin esperar a que un servicio aparte se ponga al día, y las
puntuaciones usan las estadísticas de toda la colección. Las guías de búsqueda semántica y de RAG montan los dos tipos
de índice con datos de ejemplo.
Seguro desde el primer arranque
El primer nodo crea la autoridad de certificación del clúster y el usuario root. TLS y los usuarios están activos
desde ese momento. Los nodos solo se comunican entre sí con TLS 1.3 y certificado en los dos extremos. Los roles y privilegios son
los de MongoDB, las aplicaciones pueden entrar con su certificado X.509, sin contraseña, y el cifrado en disco
viene en el mismo binario. Un mismo clúster puede además separar a varios clientes en inquilinos, cada uno con sus
usuarios y sus bases.
Para HTTP y para agentes
Cada nodo sirve también una API REST descrita con OpenAPI y un servidor MCP con las herramientas de MongoDB MCP Server. El servidor MCP arranca en solo lectura y cada llamada comprueba los privilegios de la clave de API que la hace. Ninguna de las dos cambia el protocolo de MongoDB, así que solo las usas si te convienen.
Lo que cambia respecto a MongoDB
Algunas funciones se comportan de otra forma, casi siempre con una garantía más fuerte. Un índice único lo es en todo el clúster. Un find sin sort devuelve los documentos en el orden de su clave. Lo que MongoDB marca como obsoleto
en la versión 9.0 no se implementa, salvo lo que los drivers y mongosh siguen enviando. Cada caso está en Diferencias
con MongoDB.
Por dónde empezar
Inicio rápido con un nodo te deja un nodo funcionando en unos minutos. Para varios nodos en tu máquina, sigue Inicio rápido con un clúster local, y cuando quieras construir algo concreto, las guías van paso a paso desde una API de pedidos hasta un clúster de tres máquinas con copias programadas. Cada guía arranca TeselaDB desde cero con Docker, así que puedes seguirla en tu propia máquina.
Etiquetas
- producto
- MongoDB
- clúster