Relojes híbridos sin relojes atómicos
Cómo ordena TeselaDB las versiones de los documentos con relojes lógicos híbridos y qué pasa cuando dos relojes no coinciden.
6 min de lectura
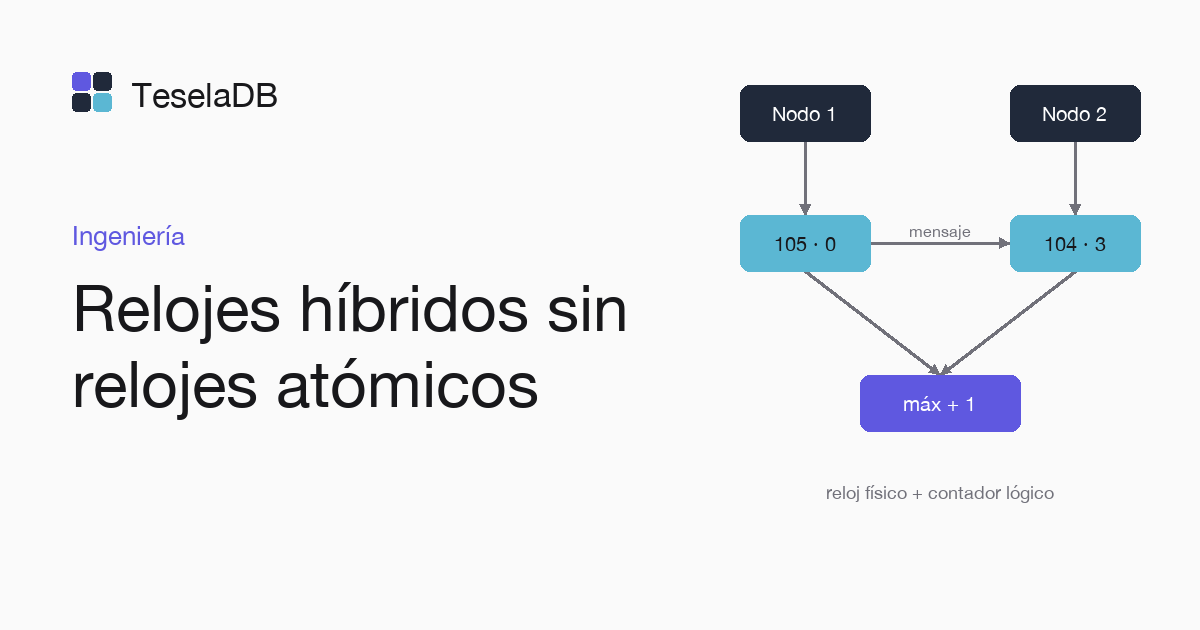
Para que una lectura vea un estado coherente de la base, cada versión de un documento necesita una marca que diga en qué orden ocurrió respecto a las demás. En una sola máquina basta con su reloj, pero en un clúster cada nodo tiene el suyo y ninguno coincide del todo con los otros. TeselaDB resuelve ese orden con relojes lógicos híbridos (HLC), sin un reloj central al que preguntar en cada escritura y sin relojes atómicos en los centros de datos.
Por qué hace falta un orden
Imagina dos escrituras sobre el mismo pedido que llegan a nodos distintos con pocos milisegundos de diferencia. Si cada nodo las sella con su reloj físico y uno va adelantado, la escritura que ocurrió después puede llevar la marca menor, y una lectura que mire las versiones por marca devolverá un pedido que ya no existe. Hace falta un orden que respete la causalidad. Los relojes híbridos lo dan sin coordinación extra. Cada marca sigue de cerca al reloj físico, así que se puede leer como una hora. Aun así, nunca retrocede frente a lo que un nodo ya ha visto.
Qué lleva una marca
marca HLC = [ 8 bytes: milisegundos físicos ][ 4 bytes: contador lógico ]Cada marca junta 8 bytes de milisegundos del reloj físico y 4 bytes de un contador lógico. Dos marcas se comparan primero por los milisegundos y, si empatan, por el contador, de modo que dentro de un mismo milisegundo un nodo puede sellar muchas versiones sin que dos coincidan. Con 4 bytes, el contador admite más de cuatro mil millones de valores distintos en cada milisegundo.
Cómo avanza el reloj de un nodo
Cada nodo avanza su marca con su reloj físico, y al recibir un mensaje que trae una marca mayor que la suya la adopta y sigue contando desde ella. Un ejemplo con números. El nodo A sella una escritura a las 10:00:00.500 y se la envía al nodo B, cuyo reloj marca 10:00:00.480 porque va 20 ms por detrás. B no sella nada por debajo de lo que ha recibido. Su siguiente marca es 10:00:00.500 con el contador en 1, y desde ahí sigue con su propio reloj en cuanto este alcanza esa hora. Si un evento de un nodo causa otro en un nodo distinto, el segundo siempre lleva la marca mayor, aunque el reloj del segundo nodo vaya retrasado.
La ventana de incertidumbre
El problema llega con escrituras que no se han comunicado entre sí. Los relojes de dos nodos pueden diferir hasta 250 ms, porque cada uno se mantiene a 125 ms o menos de la mediana del clúster. Supón una lectura con marca t que encuentra una versión escrita en otro nodo a t + 100 ms. Por las marcas, esa versión es posterior. Pero el reloj del otro nodo pudo ir adelantado, y la escritura pudo terminar antes de que empezara la lectura, sin que haya forma de saberlo desde dentro del clúster. Por eso cualquier versión que la lectura encuentre dentro de los 250 ms siguientes a su marca la obliga a reiniciarse con una marca mayor para verla. Pasa lo mismo con una escritura pendiente de una transacción y con una confirmación que la lectura descubre por el camino.
Cuándo el reinicio no se nota
Si la lectura es la primera sentencia de una transacción o una lectura suelta, el nodo la reinicia por su cuenta, y tu
aplicación solo ve que esa consulta tardó un poco más. Si la versión aparece en una sentencia posterior, la transacción ya
ha leído datos con la marca antigua y no puede cambiarla a mitad de camino. Entonces falla con WriteConflict y la
etiqueta TransientTransactionError. Los drivers de MongoDB la repiten solos, igual que repiten una transacción que
choca con otra en MongoDB, así que el código que ya maneja esos errores no cambia.
Lecturas sin incertidumbre
La ventana solo existe cuando la marca de lectura sale del reloj del nodo que atiende la lectura. Una lectura a una
marca histórica no la tiene, porque nadie le asigna esa marca en el momento. Ocurre cuando el cliente pasa atClusterTime
y cuando lee de un seguidor sin afterClusterTime, y en esos dos casos la lectura nunca se reinicia por incertidumbre,
por cerca que esté una escritura de su marca.
La espera al confirmar
Falta la otra mitad del acuerdo. Cuando una transacción se confirma, su marca de commit sale del reloj del nodo que la coordina, que puede ir por delante de los demás. Antes de responder al cliente, ese nodo espera a que su reloj de pared llegue a la marca de commit. Gracias a esa espera, cualquier transacción que empiece después de la respuesta la ve directamente o la encuentra dentro de su ventana y se reinicia para verla. La regla está comprobada con un modelo en TLA+, junto con la de la ventana.
Cuando un reloj se aleja
La ventana y la espera se apoyan en que ningún reloj se aleje más de 125 ms de la mediana. Group 0 calcula la desviación de cada nodo respecto a la mediana de los relojes de los votantes, y un nodo que la supera transfiere sus liderazgos y no acepta ninguno hasta volver al margen. Si el reloj de un nodo se adelanta 400 ms, por ejemplo, deja de liderar rangos hasta que se corrige. Por eso cada máquina del clúster necesita NTP. Sin él, esto le pasa a un nodo a menudo.
Qué ves desde tu aplicación
Las lecturas nunca devuelven un resultado que contradiga el orden real de las escrituras, aunque los relojes de tus máquinas no coincidan. A cambio, algunas lecturas se reinician y tardan un poco más. Cada nodo publica en sus métricas los reinicios por incertidumbre, junto a los commits y los abortos de transacciones por motivo. Con ellas sabes cuántas lecturas pagan ese coste, y si la cifra sube de golpe, lo primero que conviene mirar es la sincronización de los relojes. Las páginas Relojes híbridos y Consistencia y aislamiento de la documentación cuentan las mismas reglas con menos ejemplos.
Etiquetas
- HLC
- relojes
- consistencia