Cómo se mide el rendimiento de TeselaDB
Las cargas, las máquinas y las reglas con que se compara TeselaDB con MongoDB, antes de publicar ninguna cifra.
5 min de lectura
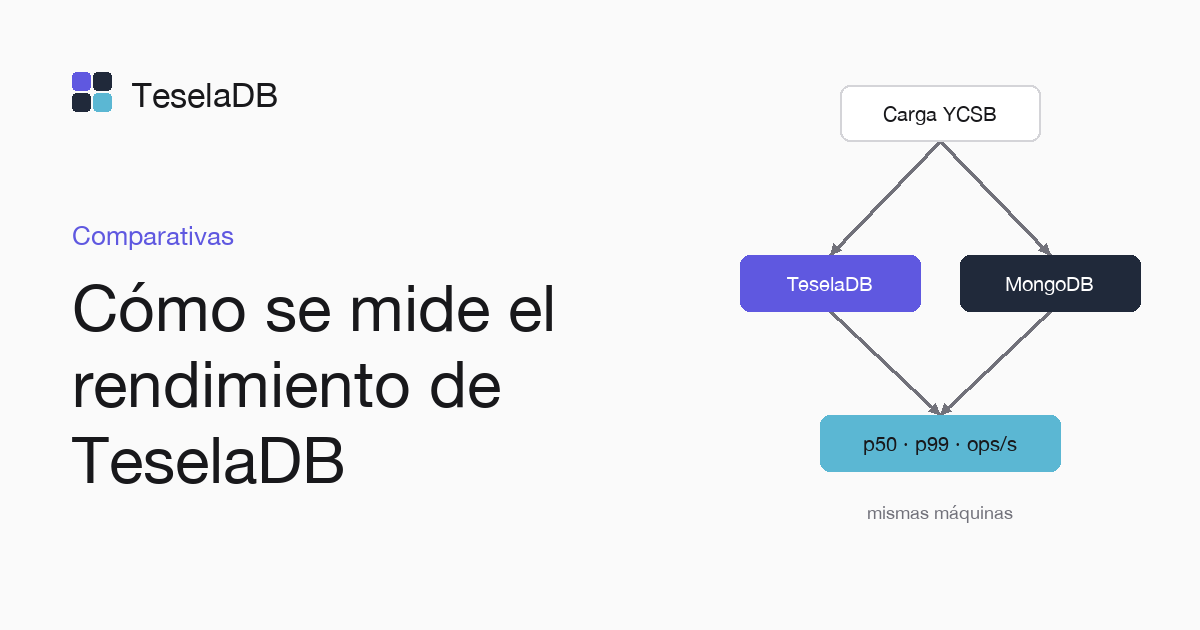
TeselaDB no publica cifras de rendimiento sin su método. Lo que sigue cuenta cómo se van a medir, con qué herramienta, con qué cargas y con qué reglas, para que puedas juzgar cada resultado cuando salga y repetirlo en tus máquinas. Hasta entonces, la página de rendimiento no muestra ningún número.
La herramienta
Todas las medidas salen de teseladb-bench, un programa del mismo repositorio que TeselaDB. Cada medida es un
escenario con nombre, y con --target el mismo escenario se lanza contra TeselaDB o contra MongoDB a través de un
cliente propio del protocolo de MongoDB, así que los dos sistemas reciben las mismas operaciones. Con una
dirección https://, el escenario rest mide la API REST.
cargo run -p teseladb-bench --release -- --scenario ycsb-a --target mongodb://127.0.0.1:27017 \
  --warmup 10s --duration 60s --concurrency 64 --json ycsb-a.json
La orden de arriba ejecuta YCSB A contra el servidor de --target. Primero calienta durante diez segundos, después mide
durante un minuto con 64 operaciones en vuelo y deja el informe en JSON.
Las cargas
Las cargas principales son YCSB A a F, según su definición publicada. Usan registros de diez campos de 100 bytes y las tres distribuciones del estándar: zipfiana, uniforme y «la más reciente». Cada letra cambia la proporción entre lecturas y escrituras, y YCSB E añade recorridos de rango, de modo que entre todas cubren desde una carga casi solo de lectura hasta una de lectura y escritura del mismo registro.
Hay además dos escenarios propios. cores-curve repite YCSB A, B y C con 1, 2, 4 núcleos y así hasta el máximo que
fijes con --max-cores, y dibuja cómo crece el rendimiento al añadir núcleos. disk-usage mide los bytes que ocupa en
disco cada documento frente a una codificación que guarda metadatos en cada campo.
Cómo se ejecuta una medida
Cada escenario tiene su calentamiento, su duración y su concurrencia, y puede correr en bucle abierto con un ritmo fijo
de operaciones por segundo, con --rate. La diferencia se ve en las latencias altas. En un bucle cerrado, un cliente que espera una respuesta lenta
deja de enviar, la carga baja justo cuando el servidor sufre y las latencias altas desaparecen de la medida. Con el
ritmo fijo, las peticiones siguen llegando y la cola se ve.
Cada medida guarda histogramas de latencia con los percentiles p50, p99 y p99,9, y escribe su informe en texto y en
JSON. Ese JSON sirve también de línea base. Con --baseline, una ejecución se compara con una anterior y falla si p50
o p99 empeoran más de un 10 %, así que una regresión de rendimiento se detecta igual que un test que falla.
Las mismas máquinas
TeselaDB y MongoDB Community corren en las mismas máquinas y con la misma carga. Cada hilo de núcleo de TeselaDB se fija a una CPU y reserva su memoria en su nodo NUMA, y cada comparación se publica con la huella de la máquina y las versiones de los dos sistemas, de forma que cualquiera puede saber en qué hardware salió cada número.
Qué se compara
YCSB A a F se mide en tres nodos. Las comparaciones con MongoDB repiten YCSB A, B y F con 3 y con 9 nodos, e incluyen
inserciones sostenidas con ObjectId como clave. También miden el SIGKILL del nodo con más líderes, con el tiempo hasta
la siguiente escritura confirmada y la fracción de operaciones que fallan. Se comparan las lecturas linealizables por
_id frente a readConcern: "linearizable" y una consulta por un campo indexado que no es la shard key, con los nodos
que toca y su latencia. Se mide el alta de un nodo en un clúster de 100 GB.
Hay una comparación menos evidente. En TeselaDB cada nodo lidera unos rangos y sigue a otros, así que reparte entre todos el trabajo que en un replica set hace un único primario. Para saber cuánto gana con eso se mide la razón F/L: F es el coste de CPU de aplicar una escritura en una réplica y L el de coordinarla en el líder, con y sin índice de búsqueda. Con R réplicas, la capacidad de escritura sale de C·R / (L + (R−1)·F) frente a C / L de un primario único, donde C es la capacidad de CPU de un nodo. Si aplicar cuesta mucho menos que coordinar, el reparto de líderes multiplica la capacidad; si cuesta casi lo mismo, la ganancia es pequeña. Solo la medida dirá cuál de los dos casos es el real.
La búsqueda se compara con MongoDB Community y mongot, en latencia y en el tiempo hasta que una escritura aparece en
los resultados. Para $vectorSearch se miden la latencia y el recall@10 con el mismo numCandidates en los dos
sistemas, porque una búsqueda vectorial más rápida que encuentra menos vecinos correctos no es una mejora.
Cuándo verás cifras
Los resultados aparecerán en la página de rendimiento con su método y la huella de las máquinas. Cada
número irá con su escenario y sus opciones, de modo que puedas lanzar la misma orden de teseladb-bench contra tu
propio clúster y comparar.
Etiquetas
- rendimiento
- YCSB
- método